Метрики и дашборды
Метрики — самый дешёвый способ узнать, что происходит с системой в целом. Но дешевизна обманчива: одна неудачная метка может увеличить число временных рядов в тысячи раз, а дашборд из сорока графиков не отвечает ни на один вопрос.
Что такое метрика
Метрика — числовое значение, измеряемое во времени и снабжённое набором меток. Уникальное сочетание имени и значений меток образует временной ряд. Большинство систем мониторинга различают несколько типов метрик.
- Счётчик (counter) только растёт: число запросов, число ошибок, отправленные байты. Сам по себе он малоинформативен, смысл имеет скорость роста — функция
rate(). - Датчик (gauge) может расти и убывать: длина очереди, занятая память, число активных соединений.
- Гистограмма (histogram) раскладывает наблюдения по корзинам: сколько запросов уложилось в 50 мс, в 100 мс, в 250 мс. Из гистограммы можно вычислить перцентили и агрегировать их между экземплярами.
Средние значения задержки почти всегда вводят в заблуждение. Если 95% запросов выполняются за 20 мс, а 5% — за 4 секунды, среднее составит около 220 мс, и эта цифра не описывает опыт ни одного пользователя. Для задержек нужны перцентили: медиана показывает типичный случай, 99-й перцентиль — то, что видит каждый сотый запрос.
Кардинальность меток
Метки делают метрики полезными: по ним можно фильтровать и группировать. Но каждая метка умножает число временных рядов на количество своих значений. Счётчик запросов с метками method (4 значения) и status (3 класса) даёт 12 рядов. Добавим instance для пяти экземпляров — 60. Добавим route для двадцати маршрутов — 1200. Всё ещё немного. А теперь добавим user_id.
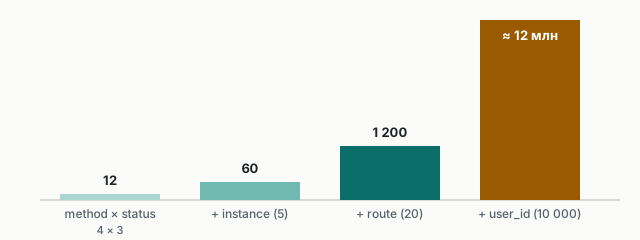
Десять тысяч активных пользователей превращают 1200 рядов в двенадцать миллионов. Каждый ряд занимает память в системе мониторинга, и такая метрика способна вывести её из строя. Правило простое: метками могут быть только значения из небольшого заранее известного множества. Идентификаторы пользователей, заказов, сессий, полные URL с параметрами, текст ошибок — не метки. Для них существуют структурированные логи и трассировки.
Пример правильной инструментации на Python с библиотекой prometheus_client:
from prometheus_client import Counter, Histogram

REQUESTS = Counter(
    "http_requests_total",
    "HTTP requests processed",
    ["method", "route", "code"],
)
LATENCY = Histogram(
    "http_request_duration_seconds",
    "HTTP request latency",
    ["route"],
    buckets=(0.01, 0.025, 0.05, 0.1, 0.25, 0.5, 1, 2.5, 5),
)

def observe(method, route_template, status, seconds):
    # route_template: "/orders/{id}", а не "/orders/99312"
    REQUESTS.labels(method, route_template, f"{status // 100}xx").inc()
    LATENCY.labels(route_template).observe(seconds)
Ключевая деталь — шаблон маршрута вместо конкретного пути. Большинство веб-фреймворков предоставляют шаблон сработавшего маршрута; именно его и нужно использовать как метку.
Агрегаты и правила записи
Запросы, которые выполняются на каждом обновлении дашборда, стоит вычислять заранее. В Prometheus для этого служат правила записи (recording rules): результат выражения сохраняется как новый временной ряд с меньшим числом меток.
groups:
  - name: http-aggregates
    interval: 30s
    rules:
      - record: route:http_requests:rate5m
        expr: sum by (route, code) (rate(http_requests_total[5m]))
      - record: route:http_request_duration_seconds:p99_5m
        expr: |
          histogram_quantile(0.99,
            sum by (route, le) (rate(http_request_duration_seconds_bucket[5m])))
Имена в формате уровень:метрика:операции — распространённое соглашение, которое сразу показывает, по каким меткам проведена агрегация и какая функция применена. Дашборды и алерты, построенные на таких рядах, работают быстрее и не ломаются, когда у исходной метрики появляется новая метка.
Как устроить дашборд
Дашборд — это ответ на вопрос. Если вопрос не сформулирован, получается витрина из всех доступных графиков, на которой невозможно ничего найти в момент инцидента. Полезно разделять дашборды по назначению.
- Обзорный отвечает на вопрос «всё ли в порядке с сервисом». На нём три-пять графиков: частота запросов, доля ошибок, задержка по перцентилям, насыщение ключевого ресурса. Этот набор иногда называют «золотыми сигналами». Его открывают первым после вызова.
- Диагностический отвечает на вопрос «почему». Здесь внутренние метрики: пулы соединений, очереди, сборка мусора, зависимости. Его открывают, когда обзорный показал проблему.
- Ёмкостный отвечает на вопрос «когда кончится ресурс». Тренды за недели и месяцы, прогнозы заполнения дисков и квот.
Несколько правил оформления делают любой дашборд читаемее. Единицы измерения подписаны на осях. Графики доли ошибок имеют фиксированную шкалу от нуля, иначе колебание с 0,01% до 0,02% выглядит катастрофой. Горизонтальная линия показывает цель SLO. Графики, которые ни разу не пригодились при разборе инцидентов за последние полгода, удаляются.
Что мерить не нужно
Метрика, которую никто не смотрит, стоит денег и ничего не даёт. Кандидаты на удаление:
- метрики, продублированные экспортёрами разных уровней — например, использование памяти, которое одновременно собирают агент узла, оркестратор и само приложение;
- метрики по каждому экземпляру там, где нужен только агрегат по сервису;
- гистограммы с десятками корзин, когда используются только медиана и 99-й перцентиль;
- метрики отладки, добавленные для расследования конкретной проблемы и оставшиеся после её решения.
Найти их помогает анализ запросов: большинство систем мониторинга позволяют узнать, какие метрики упоминаются в дашбордах, алертах и правилах записи. Всё, что не упоминается нигде и не запрашивалось вручную за последние месяцы, — кандидат на отключение на стороне приложения или отбрасывание при сборе.
topk(20, count by (__name__) ({__name__=~".+"}))Этот запрос показывает двадцать метрик с наибольшим числом временных рядов. На больших инсталляциях он тяжёлый, поэтому его лучше выполнять в спокойное время или использовать встроенную статистику базы временных рядов, если она доступна.
Итог
- Для задержек нужны перцентили из гистограмм, а не средние.
- Метки — только из небольшого известного множества значений. Идентификаторы сущностей — в логи и трассировки.
- Частые запросы выносятся в правила записи с понятными именами.
- Дашборд отвечает на один вопрос: обзорный — «всё ли в порядке», диагностический — «почему», ёмкостный — «когда кончится».
- Метрики, которые нигде не используются, отключаются.