CI и нестабильные тесты
Красная сборка — сигнал, который должен останавливать слияние. Но если она краснеет без причины каждый пятый раз, команда учится нажимать «перезапустить», не читая вывод. В этот момент CI перестаёт защищать от ошибок.
Что такое нестабильный тест
Нестабильный тест (flaky test) — тест, который на одном и том же коде в одном и том же окружении иногда проходит, а иногда падает. Ключевые слова — «на одном и том же коде». Тест, который начал падать после изменения, не нестабилен, он сломан, и это полезный сигнал.
Причины нестабильности повторяются от проекта к проекту:
- Зависимость от времени: тест проверяет, что операция завершилась за 100 мс, а на загруженной машине сборки она идёт 150. Или тест падает в полночь, потому что сравнивает даты.
- Зависимость от порядка: тест полагается на состояние, оставленное другим тестом, и падает, когда порядок выполнения меняется или тесты распараллеливаются.
- Гонки: асинхронная операция ещё не завершилась, а тест уже проверяет результат. Типичный симптом —
sleep(1)в коде теста. - Внешние зависимости: реальная сеть, общий тестовый стенд, сторонний API с ограничением частоты запросов.
- Неизолированные ресурсы: фиксированный номер порта, общий временный каталог, общая база данных для параллельных заданий.
Как обнаружить
Самый надёжный признак — разный результат на одном коммите. Если система CI хранит историю запусков, достаточно найти тесты, которые на одном и том же коммите хотя бы раз прошли и хотя бы раз упали. Такой отчёт стоит строить регулярно: раз в неделю или после каждого запуска основной ветки.
Для подозрительного теста помогает многократный прогон. Если тест падает хотя бы раз из пятидесяти запусков подряд на чистой машине, он нестабилен:
#!/usr/bin/env bash
# Usage: ./repeat.sh tests/test_orders.py::test_refund 50
set -u
target="$1"; runs="${2:-50}"; failed=0
for i in $(seq 1 "$runs"); do
  if ! pytest -q -p no:randomly "$target" > "/tmp/run-$i.log" 2>&1; then
    failed=$((failed + 1))
    echo "run $i failed, log: /tmp/run-$i.log"
  fi
done
echo "$failed of $runs runs failed"
[ "$failed" -eq 0 ]
Если тест стабильно проходит изолированно, но падает в общем прогоне, причина почти наверняка в порядке выполнения или общих ресурсах. Тогда полезно запустить набор в случайном порядке с фиксированным зерном — плагины для этого есть у большинства тестовых фреймворков — и воспроизвести падение с тем же зерном.
Карантин
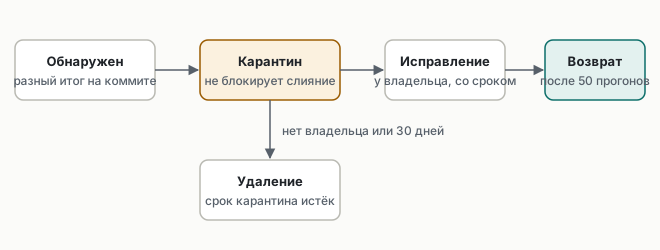
Нестабильный тест нельзя оставлять в основном наборе: он портит сигнал для всех. Но и удалять его сразу жалко — он что-то проверяет. Компромисс — карантин: тест продолжает запускаться, его результат записывается, но он не блокирует слияние.
В pytest карантин удобно реализовать маркером:
[tool.pytest.ini_options]
markers = [
    "quarantine(reason, owner, until): flaky test excluded from the blocking run",
]
addopts = "-m 'not quarantine'"
Основной прогон исключает помеченные тесты, а отдельное неблокирующее задание запускает только их: pytest -m quarantine. Тест помечается декоратором pytest.mark.quarantine(reason="race in refund worker", owner="payments", until="2026-05-15"). Обязательные атрибуты — владелец и срок. Без владельца тест не исправит никто. Без срока карантин превращается в склад тестов, которые никто не запускает. Простая проверка в CI может падать, если у какого-то теста в карантине истёк срок: это заставляет принять решение — исправить или удалить.
Политика повторных запусков
Автоматический повторный запуск — самый соблазнительный и самый опасный способ борьбы с нестабильностью. Он действительно делает сборки зелёными. Но он же прячет настоящие гонки в коде приложения: тест, который падает раз в двадцать запусков, может указывать на ошибку, которая в рабочем окружении проявится раз в двадцать запросов.
Разумная политика различает сбои инфраструктуры и сбои тестов. Повторять имеет смысл то, что не зависит от кода: потерю связи с машиной сборки, превышение времени ожидания при загрузке зависимостей, недоступность реестра образов. Пример для GitLab CI:
test:
  stage: test
  script:
    - pytest -q --junitxml=report.xml
  retry:
    max: 2
    when:
      - runner_system_failure
      - stuck_or_timeout_failure
      - scheduler_failure
  artifacts:
    when: always
    reports:
      junit: report.xml
Здесь задание повторяется только при сбое исполнителя, зависании или ошибке планировщика. Упавший тест повтора не вызывает. Если повтор на уровне тестов всё же используется, он должен быть видимым: отчёт должен показывать, что тест прошёл со второй попытки, а такие случаи — попадать в еженедельный отчёт о нестабильности.
Скорость как источник шума
Медленный конвейер тоже порождает шум, хотя и косвенно. Если сборка идёт сорок минут, разработчик переключается на другую задачу, а уведомление о результате приходит, когда контекст уже потерян. Он отправляет несколько изменений одной пачкой, и при падении непонятно, какое из них виновато.
- Быстрые проверки — форматирование, линтеры, модульные тесты — идут первыми и в отдельном задании, чтобы простые ошибки обнаруживались за минуты.
- Тяжёлые интеграционные тесты запускаются параллельно и только после того, как быстрые прошли.
- Зависимости кешируются между запусками с ключом по файлу блокировки версий.
- Тесты, которые проверяют одно и то же на разных уровнях, объединяются или удаляются.
Типичные ошибки
- Перезапуск без чтения. Если команда привыкла перезапускать красные сборки, первым делом нужно убрать нестабильные тесты, а не уговаривать людей читать логи.
- Необязательные проверки, которые никто не смотрит. Проверка, падение которой не блокирует слияние и не приводит ни к какому действию, — чистый шум. Её нужно либо сделать обязательной, либо убрать.
- Общий стенд для всех. Параллельные задания, пишущие в одну тестовую базу, гарантируют нестабильность. Каждому заданию — своё изолированное окружение.
- Вечный карантин. Список тестов в карантине, который только растёт, означает, что процесс не работает. Нужны сроки и регулярный разбор.
Итог
- Нестабильный тест — разный результат на одном коде. Он хуже отсутствующего теста, потому что учит игнорировать CI.
- Нестабильность обнаруживается по истории запусков и многократным прогонам.
- Карантин — с владельцем и сроком; отдельное неблокирующее задание продолжает запускать тесты из карантина.
- Автоматические повторы — только для сбоев инфраструктуры. Повторы тестов должны быть видны в отчётах.
- Быстрый конвейер с ранними дешёвыми проверками уменьшает шум сам по себе.