Алерты
Алерт — единственный вид сообщения, который имеет право прервать человека: разбудить ночью, отвлечь от работы, заставить бросить всё. Поэтому к алертам нужно относиться строже, чем к любым другим сообщениям системы.
Главное правило
Алерт, требующий немедленной реакции, должен отвечать трём условиям: проблема реальна (пользователи страдают или скоро начнут), срочна (ждать до утра нельзя) и требует человека (автоматика не справится). Если хотя бы одно условие не выполнено, это не вызов дежурного, а задача в очереди, запись на дашборде или строка в ежедневной сводке.
Правило звучит очевидно, но почти каждая система алертов его нарушает. Причина описана во вводной главе: добавить алерт легко, а удалить страшно. Эта глава — о том, как строить правила, которые не придётся удалять.
Симптомы и причины
Алерт по причине срабатывает на внутреннее состояние системы: загрузка процессора выше 90%, очередь длиннее тысячи сообщений, реплика базы данных отстаёт на 30 секунд. Алерт по симптому срабатывает на то, что видит пользователь: доля ошибок выросла, запросы стали медленнее, заказы перестали оформляться.
Причины плохо подходят для вызова дежурного по двум соображениям. Во-первых, высокая загрузка процессора сама по себе не проблема: система может отлично справляться с нагрузкой на 95%. Во-вторых, список возможных причин бесконечен, и на каждую новую поломку придётся добавлять новое правило, а старые при этом продолжат срабатывать. Симптомов же немного: для типичного сервиса это доступность, задержка и, иногда, корректность результата.
Это не значит, что метрики причин не нужны. Они нужны для диагностики: когда сработал алерт по симптому, дежурный открывает дашборд и видит, что загрузка процессора выросла. Но будить его должен симптом.
Параметр for и кратковременные всплески
Одиночный всплеск ошибок длиной в полминуты обычно не требует вмешательства: система восстанавливается сама. В Prometheus для этого есть параметр for — условие должно выполняться непрерывно указанное время, прежде чем алерт перейдёт из состояния pending в firing.
groups:
  - name: checkout
    rules:
      - alert: CheckoutHighErrorRate
        expr: |
          sum(rate(http_requests_total{job="checkout", code=~"5.."}[5m]))
            /
          sum(rate(http_requests_total{job="checkout"}[5m]))
            > 0.02
        for: 10m
        labels:
          severity: page
        annotations:
          summary: "Checkout: более 2% запросов завершаются ошибкой"
          runbook: "https://wiki.example.internal/runbooks/checkout-errors"
Слишком короткий for даёт шум, слишком длинный — задержку реакции. Разумная отправная точка — от 5 до 15 минут для вызова дежурного. Аннотация со ссылкой на инструкцию обязательна: человек, которого разбудили, не должен вспоминать, что делать.
Алерты от SLO
Фиксированный порог вроде «больше 2% ошибок» трудно выбрать правильно. Более надёжный подход — отталкиваться от цели уровня обслуживания (SLO). Если цель — 99,9% успешных запросов за 30 дней, то допустимая доля ошибок составляет 0,1%, а всё, что сверх, расходует бюджет ошибок.
Алерт срабатывает не на сам факт ошибок, а на скорость расходования бюджета (burn rate). Скорость 1 означает, что бюджет будет израсходован ровно за 30 дней. Скорость 14,4 — что за час сгорит 2% месячного бюджета, а весь бюджет закончится примерно за двое суток. Это уже повод будить человека.
Чтобы алерт быстро срабатывал и быстро гас, используются два окна: длинное подтверждает, что проблема значительна, короткое — что она продолжается прямо сейчас.
(
  sum(rate(http_requests_total{job="checkout", code=~"5.."}[1h]))
    / sum(rate(http_requests_total{job="checkout"}[1h]))
) > (14.4 * 0.001)
and
(
  sum(rate(http_requests_total{job="checkout", code=~"5.."}[5m]))
    / sum(rate(http_requests_total{job="checkout"}[5m]))
) > (14.4 * 0.001)
Обычно настраивают две пары: быструю (окна 1 час и 5 минут, скорость 14,4) для вызова дежурного и медленную (6 часов и 30 минут, скорость 6) тоже для вызова, а ещё более медленные — для создания задачи в рабочее время. Подход подробно описан в открытых материалах по практикам SRE и хорошо переносится на любую систему мониторинга.
Группировка, подавление, дедупликация
Когда падает база данных, одновременно срабатывают алерты всех сервисов, которые от неё зависят. Двадцать уведомлений об одном событии — классический шум. Системы маршрутизации алертов решают это тремя механизмами.
- Группировка объединяет алерты с одинаковыми метками в одно уведомление.
- Подавление (inhibition) скрывает алерты-следствия, пока активен алерт-причина.
- Дедупликация не отправляет повторное уведомление об уже известной проблеме, пока не истечёт интервал повтора.
Пример маршрутизации в Alertmanager:
route:
  receiver: checkout-tickets
  group_by: ["alertname", "service"]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    - matchers:
        - severity="page"
      receiver: checkout-oncall

inhibit_rules:
  - source_matchers:
      - alertname="DatabaseDown"
    target_matchers:
      - severity=~"page|ticket"
    equal: ["cluster"]

receivers:
  - name: checkout-oncall
  - name: checkout-tickets
Параметр group_wait задаёт, сколько ждать остальных алертов группы перед первым уведомлением, group_interval — как часто сообщать о новых алертах в уже известной группе, repeat_interval — когда напомнить о нерешённой проблеме. Интервал повтора в несколько часов обычно достаточен: если проблему подтвердили и над ней работают, ежеминутные напоминания только мешают.
Эскалация
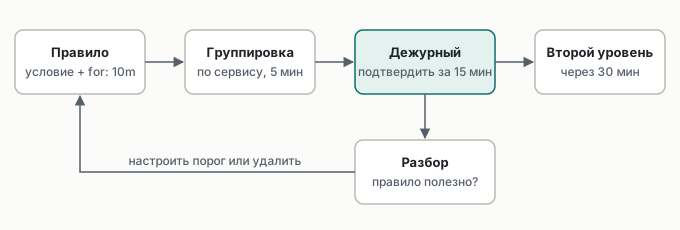
Политика эскалации отвечает на вопрос, что происходит, если дежурный не реагирует. Типичная схема: вызов основного дежурного, через 15 минут без подтверждения — повторный вызов, через 30 минут — второй уровень. Важно, чтобы подтверждение означало «я работаю над этим», а не «я увидел». Подтвердить и заснуть — хуже, чем не подтвердить: эскалация не сработает.
Последний, часто пропускаемый шаг — разбор. После каждого вызова дежурный отмечает, было ли действие (см. измерение шума). Раз в месяц команда просматривает правила с низкой долей действий и решает: поднять порог, увеличить for, перевести в задачи или удалить.
Типичные ошибки
- Уровни важности без последствий. Если «критичный» и «предупреждение» приходят в один канал одинаковым способом, различие бессмысленно. Уровень должен определять маршрут: вызов, задача или дашборд.
- Алерты без инструкции. Каждое правило, которое будит человека, должно ссылаться на документ с первыми шагами диагностики.
- Алерты на то, что исправляется само. Перезапущенный оркестратором контейнер — не повод для вызова, если перезапуски не стали систематическими.
- Общий канал для всех алертов. Канал, в который пишут сотни сообщений в день, никто не читает. У каждой команды — свой маршрут, у каждого уровня важности — свой способ доставки.
Итог
- Вызов дежурного оправдан, только если проблема реальна, срочна и требует человека.
- Будить должны симптомы; причины — для диагностики на дашборде.
- Алерты от SLO по скорости расходования бюджета с двумя окнами точнее фиксированных порогов.
- Группировка, подавление и разумный интервал повтора превращают лавину уведомлений в одно.
- Каждое срабатывание разбирается, правила с низкой долей действий пересматриваются ежемесячно.